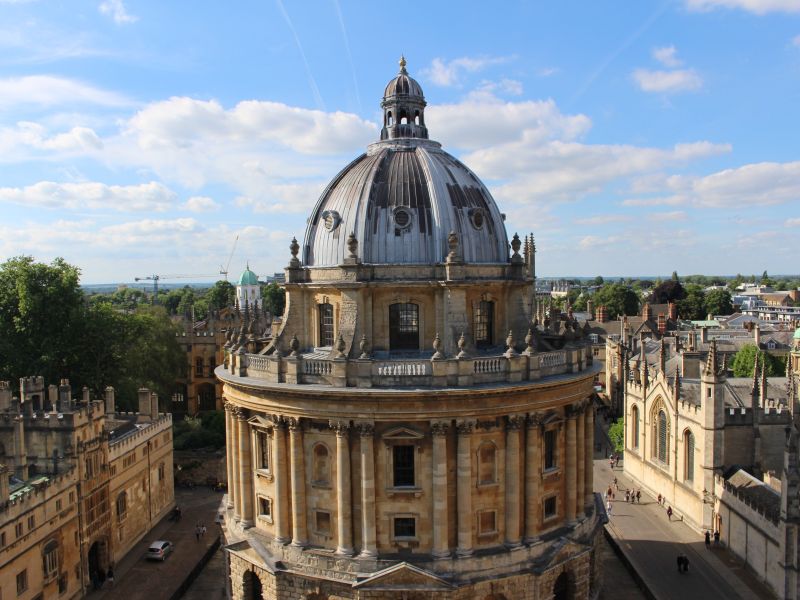
Uniwersytet Oksfordzki zezwolił OpenAI na wykorzystanie materiałów z należącej do uczelni Biblioteki Bodlejańskiej do trenowania modeli sztucznej inteligencji. Współpraca ta wpisuje się w coraz większe zainteresowanie firm technologicznych zbiorami bibliotek i instytucji akademickich, w szczególności trudno dostępnymi materiałami historycznymi. Jednym z powodów jest rosnąca liczba treści generowanych przez AI w internecie, co sprawia, że sieć staje się mniej wartościowym źródłem danych do trenowania kolejnych modeli – donosi theguardian.com.
Historyczne zbiory dla AI
Współpracę Oksfordu z OpenAI ogłoszono w marcu 2025 roku. Uniwersytet informował wówczas, że za pomocą oprogramowania firmy będzie digitalizował teksty z Biblioteki Bodlejańskiej, aby ułatwić dostęp do nich studentom i badaczom. W komunikacie nie wspomniano jednak, że zbiory mają posłużyć również do trenowania modeli sztucznej inteligencji.
Teraz, na podstawie wewnętrznych dokumentów uczelni, wiadomo więcej o dalszych losach zdigitalizowanych materiałów. Wynika z nich, że część zbiorów Biblioteki Bodlejańskiej zasiliła zbiór treningowy OpenAI. Modele sztucznej inteligencji uczą się na podstawie ogromnych ilości informacji, rozpoznając występujące w nich wzorce, co pozwala im między innymi tworzyć spójne zdania i wykonywać różnego rodzaju zadania – czytamy.
Do czerwca 2025 roku firmie przekazano 125 tys. zeskanowanych obrazów z historycznych rozpraw naukowych przechowywanych w bibliotece. Wśród nich znalazły się prace doktorskie napisane w XIX i XX wieku na europejskich i amerykańskich uniwersytetach. Zeskanowano także rzadki zbiór 10 tys. XVI-wiecznych ballad ulicznych zawierających teksty piosenek i zapisy nutowe, które były niegdyś rozpowszechniane na ulicach w czasach Tudorów.
W przyszłości współpraca może objąć znacznie większą część zbiorów Biblioteki Bodlejańskiej, liczących 23 mln obiektów. Pracownicy rozmawiali między innymi o digitalizacji XVIII-wiecznych irlandzkich dokumentów państwowych, prywatnych listów pisarki Marii Edgeworth oraz notesów Dorothy Hodgkin dotyczących penicyliny. Wśród omawianych pomysłów znalazło się również stworzenie chatbota „Ask the Bod” – dowiadujemy się.
Poszukiwania danych wychodzą poza internet
Oksford jest jedynym brytyjskim członkiem projektu NextGenAI. W ramach inicjatywy OpenAI współpracuje również z amerykańskimi instytucjami naukowymi, w tym m.in. z MIT, Caltechem, Uniwersytetem Michigan i Biblioteką Publiczną w Bostonie. Uniwersytetem Michigan i Biblioteką Publiczną w Bostonie. Jak zaznacza źródło, poszukiwania nowych źródeł danych nie ograniczają się jednak do bibliotek akademickich.
Sprzedawcy książek odnotowali falę zamówień na trudno dostępne tytuły. Wśród nich znalazły się między innymi przewodnik po narzędziach rolniczych używanych w XVIII-wiecznej Afryce oraz biografie kierowców samochodowych z lat 50. XX wieku. Właściciele antykwariatów przypuszczają, że zainteresowanie takimi książkami może wynikać z tego, że ich treść prawdopodobnie nie jest dostępna w internecie w formie cyfrowej. Dzięki temu mogą stanowić nowe źródło danych do trenowania kolejnych modeli AI.
Coraz więcej stron internetowych zawiera treści wygenerowane przez sztuczną inteligencję, przez co stają się one mniej przydatne jako materiał do trenowania nowych modeli. Firmy technologiczne coraz częściej sięgają więc po fizyczne zbiory książek, zwłaszcza starsze i trudno dostępne publikacje.
Jak donosi źródło, w przypadku Biblioteki Bodlejańskiej książki pozostają nienaruszone. Inaczej było natomiast w przypadku części publikacji kupowanych przez Anthropic, konkurenta OpenAI. Firma wydała dziesiątki milionów dolarów na zakup książek, którym odcinano grzbiety, aby można było zeskanować ich strony. Następnie publikacje trafiały na przemiał. Anthropic zapewnia jednak, że nie kupuje ani nie niszczy rzadkich i antykwarycznych pozycji.
Oksford ma swoje obawy
Współpraca Biblioteki Bodlejańskiej z OpenAI wzbudziła także obawy wśród pracowników Uniwersytetu Oksfordzkiego. Z protokołów posiedzeń uczelni, uzyskanych w ramach wniosku o udostępnienie informacji, wynika, że część kadry, w tym członkowie komitetu nadzorującego Bibliotekę Bodlejańską, zwracała uwagę na możliwe konsekwencje partnerstwa z firmą dla reputacji uczelni – podaje źródło.
Pracownicy wskazywali również na kwestie związane z ochroną środowiska. Ich obawy dotyczyły przede wszystkim dużego zużycia energii przez technologie AI oraz tego, jak wykorzystanie takich rozwiązań może wpłynąć na realizację ekologicznych zobowiązań uniwersytetu.
Rzecznik OpenAI podkreślił, że firma jest „dumna” z możliwości wykorzystania technologii do zachowania światowej wiedzy historycznej dla przyszłych pokoleń. Zaznaczył również, że skoro z technologii korzysta na co dzień ponad miliard osób, powinna ona uwzględniać różne kultury, historie i perspektywy – czytamy.
Uniwersytet Oksfordzki przekonuje z kolei, że zakres digitalizacji jest niewielki i obejmuje wyłącznie materiały, do których wygasły prawa autorskie. OpenAI nie ma wyłączności na korzystanie ze zdigitalizowanych zbiorów, a Biblioteki Bodlejańskie zachowują do nich prawa. Uczelnia zapowiedziała również, że w ciągu kilku miesięcy zacznie udostępniać te materiały publicznie w internecie, dzięki czemu będą mogły dotrzeć do znacznie większej liczby osób.
Rzecznik uczelni odrzucił także sugestię, że wykorzystanie materiałów do trenowania modeli AI było ukrywane przed opinią publiczną i studentami. Jak wyjaśnił, głównym celem projektu była digitalizacja zbiorów, ale pracownicy otwarcie informowali również, że przedsięwzięcie przyczyni się do stworzenia danych wykorzystywanych do trenowania modeli. (ao)
Źródło: theguardian.com, Oxford lets OpenAI train its AI models on Bodleian Library, Ethan Penny, Dan Milmo, 26.09.2026